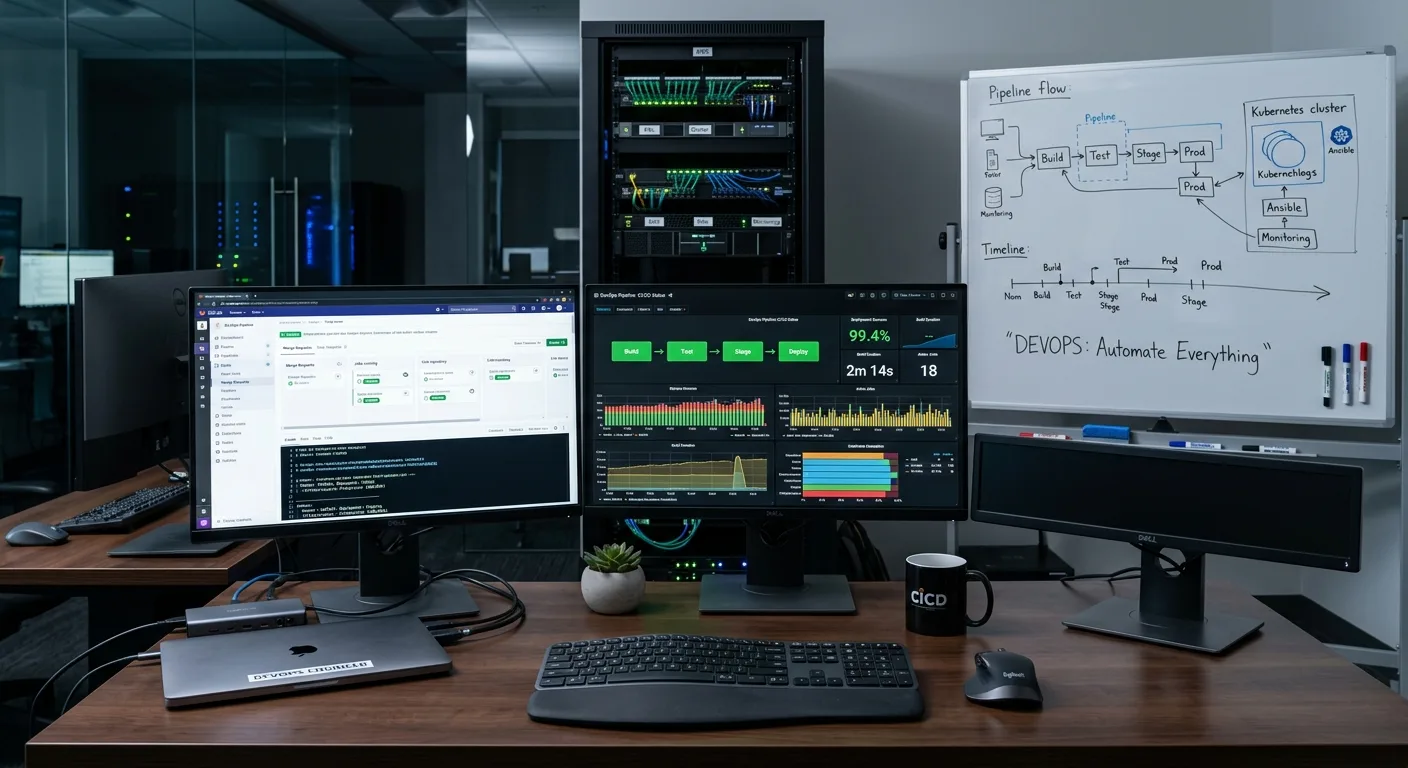
Definicija i važnost nadzora u DevOps-u
Nadzor u DevOps kontekstu obuhvaća prikupljanje, analizu i vizualizaciju podataka o performansama i ponašanju aplikacija te infrastrukture. To uključuje metrike sustava, performanse aplikacija i korisničko iskustvo. Cilj je osigurati transparentnost i uvid u rad sustava u svakom trenutku.
Važnost nadzora leži u njegovoj sposobnosti da pruži uvid u stanje sustava u stvarnom vremenu, omogućujući proaktivno prepoznavanje anomalija i potencijalnih problema. Bez učinkovitog nadzora, timovi bi bili reaktivni, rješavajući probleme tek nakon što se korisnici susretnu s poteškoćama, što dovodi do prekida usluga i nezadovoljstva.
Strategije centraliziranog logiranja i analize
Centralizirano logiranje podrazumijeva prikupljanje logova iz različitih izvora – aplikacija, poslužitelja i mrežnih uređaja – na jednoj centralnoj lokaciji. Ova strategija omogućuje brzu pretragu, analizu i korelaciju događaja iz cijelog sustava, što je ključno za dijagnostiku problema i sigurnosne revizije.
Analiza logova, često potpomognuta strojnim učenjem, može otkriti skrivene obrasce i anomalije koje bi inače ostale neprimijećene. Korištenjem alata za analizu logova, timovi mogu identificirati korijenske uzroke problema, optimizirati performanse i poboljšati sigurnosnu poziciju cijelog okruženja.
Pravi nadzor nije samo prikupljanje podataka, već sposobnost da se na temelju tih podataka brzo i inteligentno djeluje.
Alati za nadzor performansi i zdravlja aplikacija
Postoji širok spektar alata za nadzor performansi aplikacija (APM) i zdravlja sustava. Od platformi otvorenog koda poput Prometheus-a i Grafana-e do komercijalnih rješenja, svaki alat nudi specifične mogućnosti prikupljanja metrika, vizualizacije i postavljanja pragova upozorenja. Pravi izbor alata ovisi o specifičnim potrebama i kompleksnosti sustava.
Implementacija ovih alata omogućuje detaljan uvid u CPU usage, memoriju, disk I/O, mrežni promet, kao i specifične performanse aplikacija poput vremena odziva i broja grešaka. Kontinuiranim praćenjem ovih parametara, timovi mogu osigurati optimalan rad i brzo reagirati na bilo kakva odstupanja od očekivanih performansi.
Implementacija upozorenja i automatiziranih odgovora
Učinkovit nadzor nije potpun bez sustava upozorenja koji obavještava relevantne timove o kritičnim događajima. Upozorenja moraju biti konfigurirana tako da su relevantna, pravovremena i da sadrže dovoljno konteksta za brzo razumijevanje problema. Previše lažnih upozorenja može dovesti do tzv. "umora od upozorenja".
Automatizirani odgovori na upozorenja predstavljaju sljedeći korak u optimizaciji. To može uključivati automatsko skaliranje resursa, ponovno pokretanje neuspjelih servisa ili pokretanje dijagnostičkih skripti. Takva automatizacija smanjuje potrebu za ljudskom intervencijom i značajno ubrzava oporavak sustava, povećavajući njegovu otpornost.